RAG ve Fine-Tuning: Production AI için Doğru Mimariyi Seçmek
 by Batuhan Şahin
6 Ekim 20266 dk okuma
by Batuhan Şahin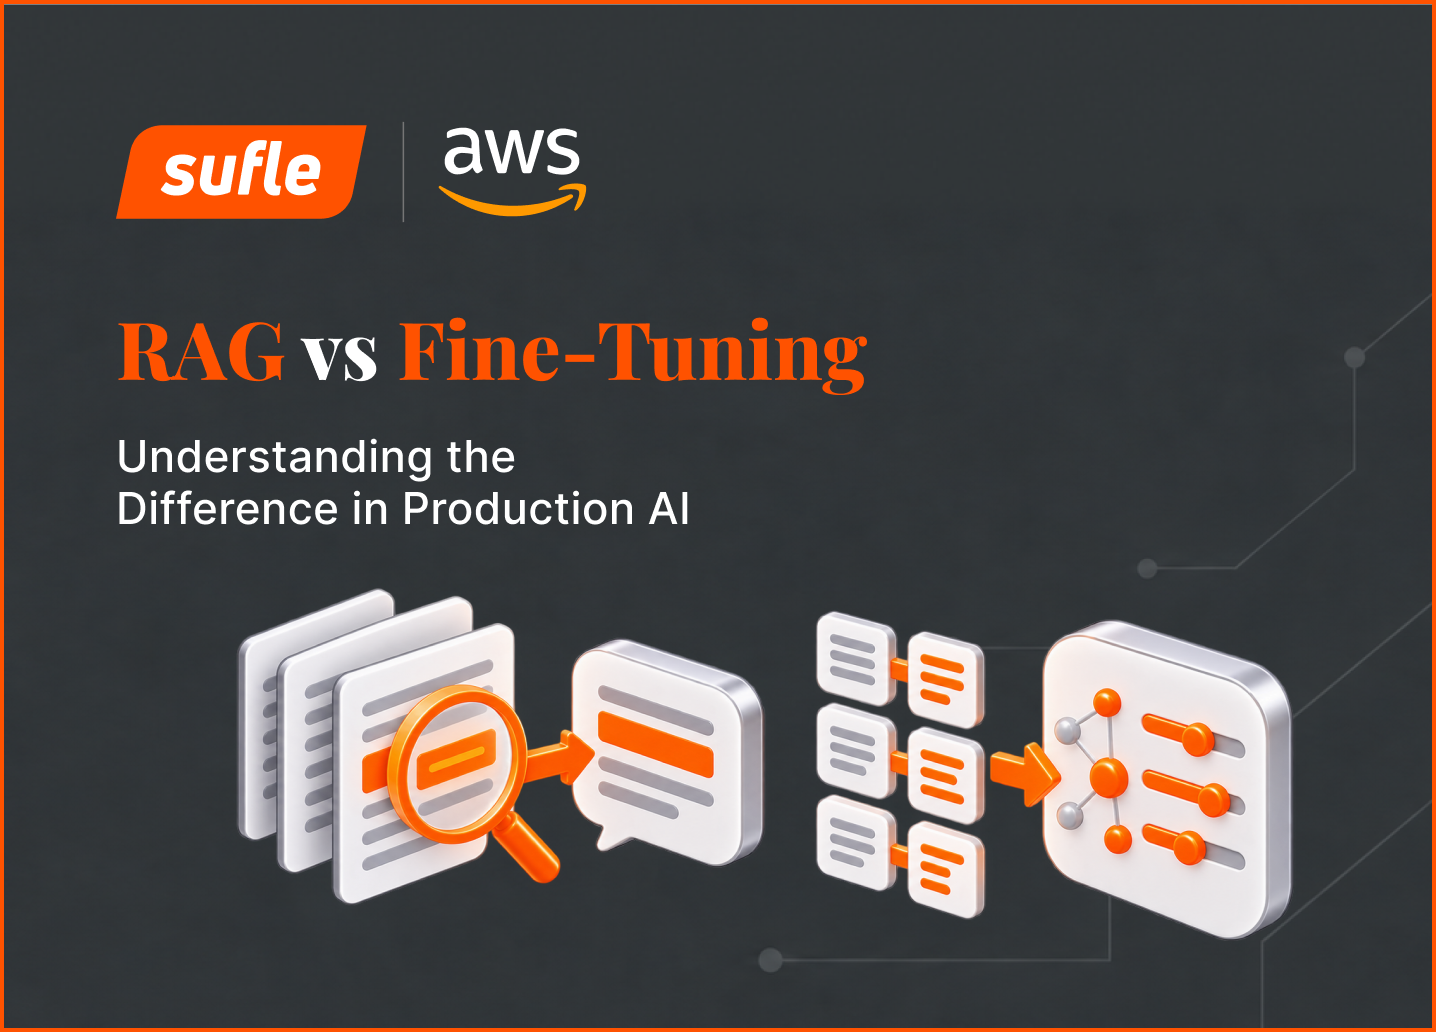


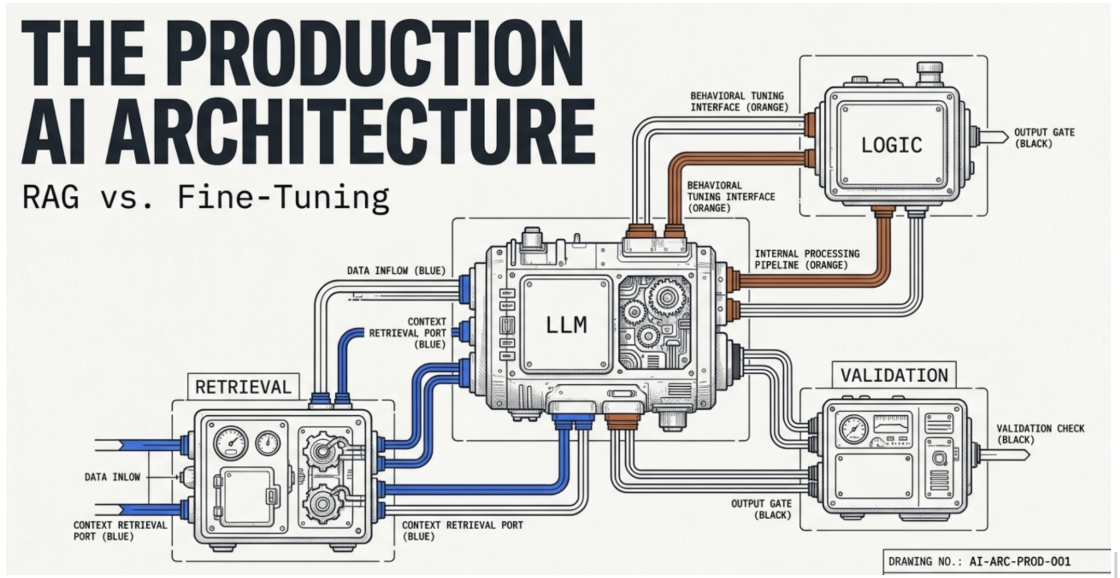
LLM’lerle çalışmaya ilk başladığımda, RAG ve fine-tuning’in bir AI uygulamasındaki yerini anladığımı düşünüyordum. Daha önce anlamsal arama, geçmiş kullanıcı verileri, özel prompt’lar ve yapılandırılmış çıktılarla çalışmıştım. Ancak daha sonra RAG olarak değerlendirdiğim sistemlerden birinin aslında eksiksiz bir RAG mimarisi izlemediğini fark ettim. Bu deneyim, her iki yaklaşıma da farklı bir açıdan bakmamı sağladı.
Bir geliştirici olarak yalnızca bir LLM API’sini çağırmak ile bir LLM’i production ortamındaki bir uygulamaya entegre etmek arasında önemli bir fark olduğunu düşünüyorum.
Bir API çağrısı bize yanıt verebilir; ancak bu yanıt her zaman uygulamamızın ihtiyaç duyduğu niteliklere sahip olmayabilir. Fazla genel kalabilir, yanlış bir formatta gelebilir, uygulamanın belirlediği kapsamın dışına çıkabilir veya kullanım doğru şekilde kontrol edilmediğinde maliyetleri artırabilir.
Benim için hedef, “AI ekledik ve çalışıyor” demek değil. Hedef; uygulamanın kurallarına ve gereksinimlerine uyan, faydalı ve öngörülebilir sonuçlar üreten AI destekli bir uygulama geliştirmek.
RAG ve fine-tuning gibi yaklaşımları anlamak tam da bu noktada önem kazanıyor. Bu yazıda iki yaklaşımın hangi problemleri çözdüğünü, birbirlerinden nasıl ayrıldığını ve production ortamındaki uygulamalarda hangi durumlarda anlamlı olabileceğini ele alacağız.
Bir LLM API’sini çağırmak genellikle sürecin en kolay kısmıdır. Asıl zorluk, modeli gerçek bir uygulamaya entegre ettiğimizde başlar. Uygulamanın kendine özgü verileri, iş kuralları, güvenlik gereksinimleri, yanıt formatları ve maliyet kısıtları vardır. LLM ise bu gereksinimleri kendiliğinden bilmez veya otomatik olarak uygulamaz.
Örneğin bir AI asistanının, şirket içi dokümantasyonu kullanarak soruları yanıtlaması gerekebilir. Soruyu doğrudan bir LLM’e gönderdiğimizde makul bir yanıt alabiliriz; ancak model, uygulamanın ihtiyaç duyduğu güncel veya kuruma özgü bilgilere erişemeyebilir.
Bu nedenle yalnızca modelin kendisini değil, aşağıdaki noktaları da değerlendirmemiz gerekir:
Model hangi bilgilere erişebilmeli?
Bu bilgiler nasıl getirilmeli?
Yanıt nasıl yapılandırılmalı?
Maliyet ve güvenilirlik nasıl kontrol edilmeli?
Basit bir API çağrısı şu şekilde işler:
Prompt → LLM → Response
Production ortamındaki bir AI uygulaması ise daha kapsamlı bir akışa sahiptir:
User → Application Logic → Context or Retrieval → LLM → Validation → Response
LLM, mimarinin yalnızca bir parçasıdır. RAG ve fine-tuning; uygulamanın modele nasıl bilgi sağladığı ve modelin nasıl davrandığıyla ilgili farklı problemleri çözmemize yardımcı olur.
RAG, Retrieval-Augmented Generation anlamına gelir. Bir LLM’in yanıt üretirken harici bilgilerden yararlanmasını sağlar.
Yalnızca kullanıcının sorusunu modele göndermek yerine, uygulama önce ilgili bilgileri getirir ve bu bilgileri prompt’a ekler.
User Query → Retrieve Relevant Information → LLM → Response
Yaygın bir uygulamada embedding’ler ve Pinecone gibi bir vektör veri tabanı kullanılır. Embedding modeli metni vektörlerle temsil eder; böylece bilgiler, tam anahtar kelime eşleşmesi yerine anlamsal benzerliğe göre bulunabilir.
Örneğin bir kullanıcı şu soruyu sorabilir:
“Şifremi nasıl sıfırlayabilirim?”
Sistem, aşağıdaki bilgiyi içeren bir dokümanı bulabilir:
“Şifrenizi unuttuysanız giriş sayfasından yeni bir şifre oluşturabilirsiniz.”
Bu bilgi daha sonra LLM’e bağlam olarak sunulur.
Buradaki önemli ayrım şudur: Bir vektör veri tabanı kullanmak, tek başına RAG kullandığımız anlamına gelmez. Getirilen bilginin, LLM’in yanıt üretirken kullandığı bağlama dahil edilmesi gerekir.
Aynı RAG mimarisi, yönetilen AWS servisleri kullanılarak da oluşturulabilir.
Örneğin Amazon Bedrock Knowledge Bases RAG iş akışını yönetirken Amazon OpenSearch Serverless vektör deposu olarak kullanılabilir. Dokümanlar Amazon S3 gibi bir kaynakta tutulabilir, embedding’lere dönüştürülebilir ve anlamsal arama için indekslenebilir.
Basitleştirilmiş mimari şu şekilde görünür:
S3 → Bedrock Knowledge Base → Embeddings → OpenSearch Serverless
Çalışma zamanındaki akış ise şöyledir:
User Query → Bedrock Knowledge Base → Relevant Context → Foundation Model → Response
Bu yaklaşım, RAG sürecinin her parçasını sıfırdan geliştirmek yerine yönetilen AWS servislerinden yararlanmamızı sağlar. Amazon Bedrock Knowledge Bases, bilgi getirme sürecini yönetir ve getirilen bağlamı modelin prompt’una ekleyebilir.
Pinecone da geçerli bir alternatiftir. Amazon Bedrock Knowledge Bases, Pinecone’u vektör deposu olarak desteklediği için tercih yalnızca tamamen AWS servislerine dayalı bir yapı ile Pinecone arasında olmak zorunda değildir.
Kısacası RAG temel olarak şu soruya yanıt verir:
“Model bu isteği yanıtlarken hangi bilgileri görmeli?”
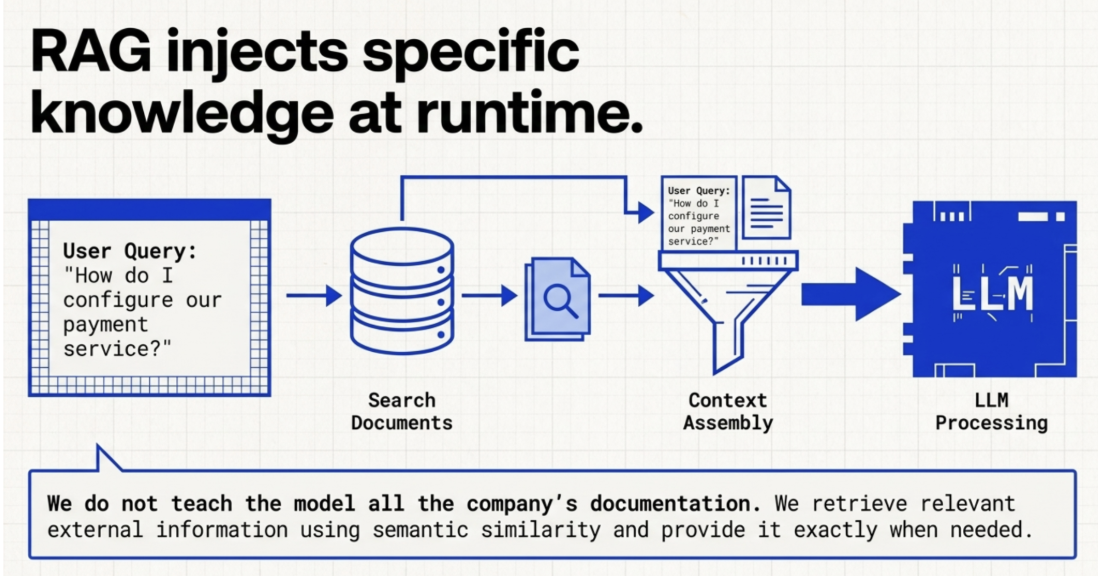
Bir şirket için kurum içi bir AI asistanı geliştirdiğimizi düşünelim. Şirketin ürünleri, iç süreçleri ve teknik yönergeleri hakkında bilgi içeren binlerce dokümanı bulunuyor ve bu bilgiler zaman içinde değişebiliyor.
LLM’e doğrudan şu soruyu yönelttiğimizi varsayalım:
“Ödeme servisimizi nasıl yapılandırabilirim?”
Model, şirketin güncel dokümantasyonuna erişemeyebilir. RAG kullanıldığında uygulama önce ilgili dokümanları arar ve bulunan içeriği LLM’e sağlar.
User Query → Search Documents → Relevant Context → LLM → Response
Model daha sonra yanıtını getirilen bilgilere dayanarak oluşturabilir. Buradaki önemli nokta, şirketin tüm dokümantasyonunu modele öğretmeye çalışmamamızdır. Modele, yalnızca ilgili istek sırasında ihtiyaç duyduğu bilgiyi sağlarız. Bu, RAG ile fine-tuning arasındaki temel farklardan biridir.
Fine-tuning, önceden eğitilmiş bir modeli ek örneklerle eğiterek daha spesifik bir görev veya davranışa uyarlama sürecidir.
Modele istek sırasında yeni bilgi vermek yerine, belirli girdi türlerine nasıl yanıt verdiğini değiştiririz.
Basitleştirilmiş akış şu şekildedir:
Pre-trained Model + Training Examples → Fine-tuned Model
Örneğin müşteri destek mesajlarının nasıl kategorize edilmesi gerektiğini gösteren binlerce örneğimiz olduğunu düşünelim. Bu örnekleri kullanarak modeli belirli bir sınıflandırma görevini gerçekleştirecek şekilde uyarlayabiliriz.
Bu yaklaşım RAG’den farklıdır. RAG’de bilgi çalışma zamanında getirilerek modele sunulur. Fine-tuning’de ise eğitim verileri kullanılarak modelin kendisi belirli bir göreve veya davranışa uyarlanır.
Aradaki farkı hatırlamanın kolay bir yolu:
RAG: “Model hangi bilgiyi görmeli?”
Fine-tuning: “Model nasıl davranmalı?”
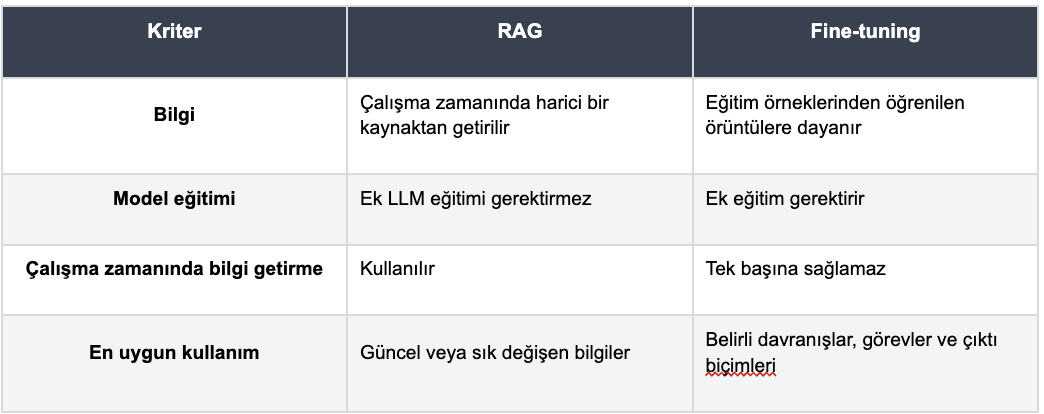
RAG ve fine-tuning, LLM destekli bir uygulamayı geliştirmek için alternatif yöntemler olarak sıkça karşılaştırılır. Ancak iki yaklaşım farklı problemleri çözer.
RAG, modelin belirli bir istek için erişebildiği ve kullanabildiği bilgiyi değiştirir. Fine-tuning ise modelin nasıl davrandığını değiştirir.
Örneğin uygulamanın sık güncellenen şirket dokümantasyonunu kullanarak soruları yanıtlaması gerekiyorsa RAG, ilgili bilgiyi çalışma zamanında sağlayabilir. Uygulamanın çok sayıda örneğe dayanarak belirli bir görevi tutarlı biçimde yerine getirmesi gerekiyorsa fine-tuning değerlendirilebilir.
Bazı senaryolarda iki yaklaşıma birlikte ihtiyaç duyulabilir. Uygulama, en güncel bilgileri sağlamak için RAG kullanırken belirli bir davranış veya görev için fine-tuned bir modelden yararlanabilir.
RAG ve fine-tuning arasındaki seçim, öncelikle çözmeye çalıştığımız probleme bağlıdır.
Bir şirketin dokümantasyonu hakkında soruları yanıtlayan bir AI asistanı düşünelim. Dokümantasyon düzenli olarak değiştiği için her güncellemede modeli yeniden eğitmek pratik olmayacaktır. RAG, en güncel ve ilgili bilgileri getirmemize ve çalışma zamanında modele sunmamıza olanak tanır.
Şimdi binlerce müşteri mesajını önceden belirlenmiş kategorilere ayırması gereken bir uygulama düşünelim. Yüksek kaliteli örneklerden oluşan kapsamlı bir veri setimiz varsa fine-tuning, modelin bu özel göreve uyarlanmasını sağlayabilir.
Buradaki amaç modele sürekli değişen bilgiler sağlamak değil, modeli belirli bir göreve daha uygun hâle getirmektir.
Bazı uygulamalar her iki yaklaşımdan da yararlanabilir. Örneğin bir AI destek asistanının güncel ürün dokümantasyonuna erişmesi ve aynı zamanda belirli bir yanıt stilini ve sınıflandırma sürecini izlemesi gerekebilir.
Bu senaryoda RAG ilgili ve güncel bilgileri sağlayabilir; fine-tuning ise modelin uygulamaya özgü davranışa uyarlanmasına yardımcı olabilir.
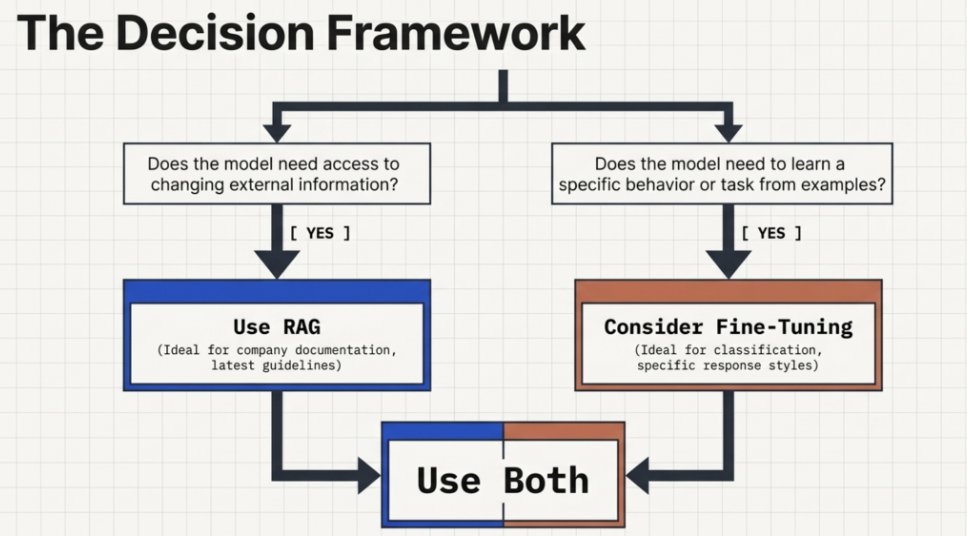
Karar sürecine şu iki soruyla başlayabiliriz:
Modelin değişen harici bilgilere erişmesi gerekiyor mu? RAG’i değerlendirin.
Modelin örneklerden belirli bir davranışı veya görevi öğrenmesi gerekiyor mu? Fine-tuning’i değerlendirin.
Her iki sorunun yanıtı da evetse iki yaklaşımın birlikte kullanılması uygun olabilir.
RAG ve fine-tuning farklı problemleri çözer. RAG, çalışma zamanında doğru bilgiyi modele sağlamamıza yardımcı olurken fine-tuning, modeli belirli bir görev veya davranışa uyarlamamızı sağlar. Bazı uygulamalarda ise iki yaklaşımın birlikte kullanılması anlamlı olabilir.
Temel çıkarım şu: Production ortamındaki bir AI uygulaması, bir LLM API çağrısının ötesinde kapsamlı bir mimari gerektirir. Modelin etrafındaki bu mimariyi, üretilen yanıtların uygulamanın gereksinimlerine uyacağı şekilde tasarlamamız gerekir.
Çözmeye çalıştığımız problemi doğru anlamak, uygun yaklaşımı seçmenin ilk adımıdır.

RAG, fine-tuning veya hibrit yaklaşımlardan hangisinin kullanım senaryonuza uygun olduğunu değerlendiriyor musunuz? AWS üzerinde güvenli, ölçeklenebilir ve üretime hazır bir AI mimarisi tasarlamak için Sufle ile iletişime geçin.

Batuhan, ölçeklenebilir web uygulamaları, cloud-native sistemler ve AI destekli çözümler geliştirmeye odaklanan bir Full-Stack Software Engineer’dır. Backend geliştirme, dağıtık sistemler, otomasyon ve AWS bulut mimarileri alanlarında deneyim sahibidir. Güvenilir ve sürdürülebilir sistemler geliştirmeye önem veren Batuhan; karmaşık mühendislik problemlerini çözmekten, fikirleri uygulanabilir çözümlere dönüştürmekten ve cloud ile AI teknolojilerindeki yenilikleri takip etmekten keyif alır.
Teknoloji kullanımımız, çözümlerimiz ve rehberlerimizle ilgili en son güncellemeleri ve makaleleri keşfedin.
Size daha iyi bir deneyim sunmak için çerez kullanıyoruz.